Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
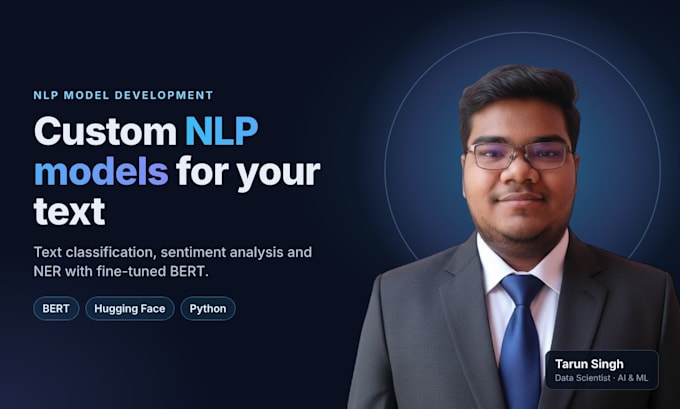
Ingénieur IA, développeur LLM, RAG et NLP
Vous cherchez un modèle qui comprend votre texte : avis, tickets de support, e-mails, commentaires ou documents ?
Je conçois et ajuste des modèles NLP avec BERT, RoBERTa et DistilBERT qui transforment du texte brut en prévisions précises.
Ce que je peux construire :
Ce que vous obtenez :
Pourquoi moi ?
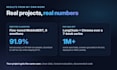
Je suis Data Scientist, je travaille sur le NLP et les LLM au quotidien. J’ai affiné MobileBERT pour atteindre 91,9 % de précision sur une détection d’émotions à 6 classes, puis j’ai réduit sa taille par quantification tout en conservant 91,1 %. Au travail, je développe des pipelines LangChain LLM et des services FastAPI en production.
Envoyez-moi vos données et votre objectif avant de commander, et je vous proposerai le bon package.
Langage de programmation:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
MLflow
•
Colab
Traduction automatique
Quelles données dois-je fournir ?
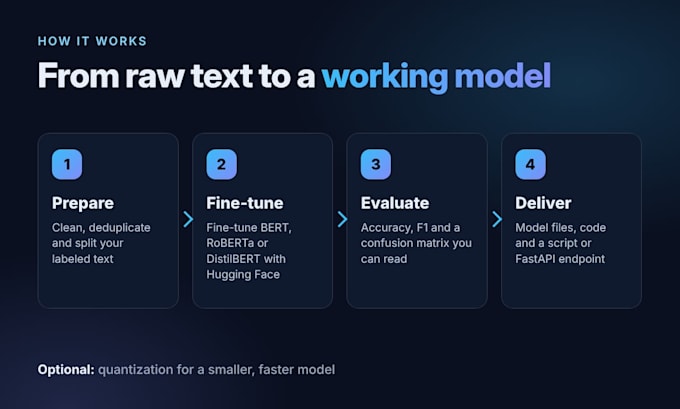
Un fichier CSV ou Excel avec votre texte et vos étiquettes fonctionne le mieux. Pas encore d’étiquettes ? Je peux proposer un plan d’étiquetage ou utiliser des méthodes zero-shot et basées sur des LLM pour démarrer.
Quels modèles utilisez-vous ?
BERT, RoBERTa, DistilBERT ou MobileBERT, et des LLM open-source comme Llama ou Mistral via Hugging Face. Je choisis le plus petit modèle qui répond à vos besoins en précision et en rapidité.
Pouvez-vous garantir une précision spécifique ?
Personne ne peut honnêtement promettre la précision avant de voir les données. Je fournis une ligne de base rapidement, j’explique clairement les résultats et j’améliore le modèle lors des révisions de votre package.
Pourrai-je exécuter le modèle moi-même ?
Oui. Vous obtenez les fichiers du modèle entraîné, le code et un simple script d’inférence. L’ajout standard comprend un endpoint FastAPI, et l’offre Premium comprend Docker et déploiement sur le cloud.
Travaillez-vous avec des langues autres que l’anglais ?
Oui. J’utilise des modèles multilingues tels que XLM-RoBERTa et mBERT, y compris le hindi et d’autres langues indiennes.
Mes données restent-elles privées ?
Vos données ne seront utilisées que pour votre projet et ne seront jamais partagées. Je supprime mes copies après livraison si vous le demandez.