Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
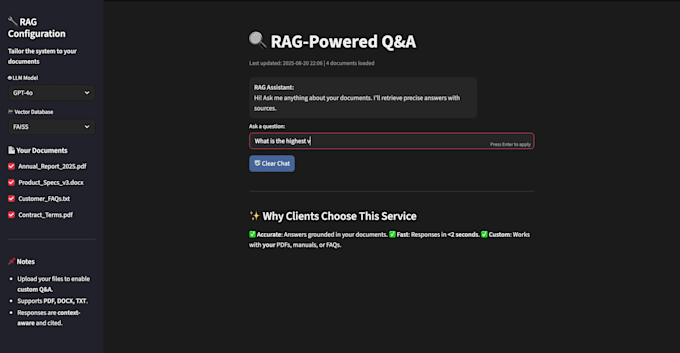
Vous souhaitez booster vos applications d'IA avec Retrieval-Augmented Generation (RAG) ? Vous êtes au bon endroit !
Je concevrai et mettrai en œuvre un pipeline RAG prêt pour la production qui combine la puissance des modèles de langage de grande taille (LLMs) avec des systèmes de récupération intelligents, permettant à votre IA de fournir des réponses précises, contextuelles et à jour.
Ce que je propose :
Développement complet du pipeline RAG (retriever + générateur)
Intégration avec des bases de données vectorielles (Pinecone, Weaviate, FAISS, Milvus, etc.)
Ingestion de documents et découpage avec embeddings
Déploiement prêt à l'emploi via API (FastAPI/Flask)
Fine-tuning pour des cas d’usage spécifiques
Intégration d’une IA explicable pour plus de transparence
Optimisation pour la scalabilité et la latence
Cas d’usage :
Pourquoi me choisir ?
En tant qu'ingénieur ML/IA et développeur Python expérimenté, j’ai créé des solutions RAG concrètes qui sont évolutives, flexibles et adaptées aux besoins des entreprises. Je fournis un code propre, documenté et prêt pour la production pour que vous puissiez évoluer en toute confiance.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Langues
Traduction automatique
Traduction automatique
Qu’est-ce qu’une solution RAG ?
Une solution RAG (Retrieval-Augmented Generation) combine un récupérateur (pour extraire des connaissances pertinentes d’une base de données) avec un générateur (LLM comme GPT) pour fournir des réponses précises, contextuelles et fiables.
Pourquoi ai-je besoin d’un RAG plutôt qu’un LLM classique ?
Les LLM standards peuvent halluciner ou donner des réponses obsolètes. Avec RAG, votre IA a accès à des connaissances en temps réel et spécifiques au domaine, ce qui garantit la précision, la fiabilité et une réduction des hallucinations.
Quelles bases de données vectorielles supportez-vous ?
Je supporte Pinecone, Weaviate, FAISS, Milvus, Chroma et ElasticSearch. Si vous avez une autre préférence, je peux aussi l’intégrer.
Pouvez-vous déployer la solution en production ?
Oui ! Je peux déployer votre pipeline RAG en tant qu’API (FastAPI/Flask), l’intégrer dans des chatbots ou applications web, et le configurer pour la scalabilité dans des environnements cloud (AWS, GCP, Azure, etc.) (Plan spécifique uniquement).
Ai-je besoin de mon propre LLM ou pouvons-nous utiliser OpenAI/others ?
Les deux sont possibles ! Je peux intégrer OpenAI, Anthropic, Cohere, HuggingFace ou votre propre LLM fine-tuné selon vos besoins.
Pouvez-vous le rendre spécifique à un domaine (juridique, médical, financier, etc.) ?
Absolument ✅. Je peux fine-tuner les embeddings, la logique de récupération et la configuration du pipeline pour des applications spécifiques à un domaine, afin que votre solution RAG corresponde à votre secteur.
Comment garantissez-vous la confidentialité et la sécurité des données ?
J’utilise des pipelines sécurisés, des bases de vecteurs privées et des API à accès contrôlé pour protéger vos données sensibles. Le déploiement peut se faire sur vos serveurs ou dans vos comptes cloud pour un contrôle total.
De quoi ai-je besoin pour commencer ?
Partagez simplement vos besoins, les données disponibles (documents, base de connaissances, etc.) et la technologie préférée. Je vous guiderai pour le reste !