Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Level 2
Traduction automatique
Envoyer des données sensibles d'entreprise à des serveurs d'IA publics représente un risque sérieux pour la vie privée et les coûts API mensuels s'accumulent rapidement.
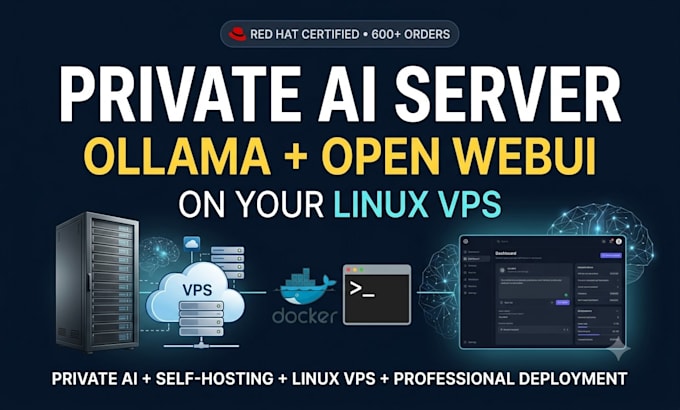
Je vais déployer un chatbot IA entièrement privé et auto-hébergé sur votre VPS Linux en utilisant Ollama + Open WebUI, offrant à votre équipe une expérience sécurisée semblable à ChatGPT sans frais récurrents.
En tant qu'ingénieur certifié Red Hat (RHCSA/RHCE, plus de 14 ans d'expérience, plus de 600 commandes), je ne me contente pas de l'installer ; je le sécurise pour qu'il ne soit pas exposé en ligne.
Ce que je ferai :
Installer et configurer Docker, Ollama et Open WebUI
Déployer des LLM open-source (Llama 3, Mistral, DeepSeek, Qwen)
Configurer un proxy inverse Nginx avec SSL (HTTPS)
Activer le streaming en temps réel des tokens
Configurer le panneau d'administration, l'authentification des utilisateurs et l'accès multi-utilisateur
Inclure pare-feu et sécurisation de base du serveur
Mettre en place RAG pour la requête de PDF/document (Standard & Premium)
Documentation complète de la configuration
Pourquoi choisir ce service :
100% privé vos données ne quittent jamais votre serveur
Pas de coûts API, pas de limite de tokens
Prêt pour la production, stable et sécurisé
Compatible avec tout VPS : DigitalOcean, Hetzner, Vultr, Contabo, AWS, Linode. Support GPU et CPU uniquement.
Remarque : la performance du modèle dépend de votre CPU/RAM/GPU.
Contactez-moi avant de commander pour confirmer vos spécifications et objectifs.
Linux Server Security Expert cPanel WHM Cloudflare Docker RHCSA RHCE
Level 2
Langues
Traduction automatique
Traduction automatique
Quelles sont les exigences minimales pour le serveur ?
Pour des modèles légers comme Llama 3.2 (3B) ou Mistral, il faut au moins 4 Go de RAM et 2 cœurs CPU. Pour des modèles plus grands (8B+), je recommande 8 Go à 16 Go de RAM. Vous n'êtes pas sûr de vos spécifications ? Partagez-les avant de commander et je vous conseillerai le meilleur modèle pour votre matériel.
Mes données sont-elles vraiment privées ?
100% oui. Tout fonctionne sur votre propre serveur — vos chats, documents et données ne quittent jamais votre machine. Il n'y a aucun appel API à OpenAI ou à un tiers. Confidentialité totale par conception.
Ai-je besoin d'une clé API OpenAI ou d’un abonnement ?
Non. Cette configuration utilise des modèles open-source gratuits via Ollama. Une fois déployé, vous pouvez utiliser l'IA sans limite — pas de frais par token, pas de coûts mensuels, jamais de clés API.
Cela peut-il fonctionner sans GPU ?
Absolument. Je me spécialise dans l'optimisation des modèles pour les environnements VPS uniquement CPU en utilisant la quantification 4 bits. Un GPU offre des réponses plus rapides, mais les CPU modernes gèrent étonnamment bien les tâches quotidiennes.
Mon équipe peut-elle utiliser cela ensemble ?
Oui. Les packages Standard et Premium incluent l'authentification multi-utilisateur. Vous disposez d'une console d'administration pour créer des comptes, gérer l'accès et contrôler qui utilise la plateforme.
Qu'est-ce que RAG et en ai-je besoin ?
RAG (Retrieval-Augmented Generation) permet à votre IA de répondre à des questions à partir de vos propres documents privés — PDFs, fichiers Word, fichiers texte. Téléchargez un document et posez-lui n'importe quelle question. Inclus dans les packages Standard et Premium.
Quelle distribution Linux recommandez-vous ?
Ubuntu 22.04 LTS ou 24.04 LTS est fortement recommandé pour une meilleure stabilité et compatibilité. Je peux également travailler avec Debian, CentOS ou AlmaLinux si nécessaire.
Et si mon VPS n'a pas assez de RAM pour le modèle que je souhaite ?
Je vérifierai vos spécifications après votre commande. Si votre matériel ne supporte pas le modèle préféré, je recommanderai la meilleure alternative et vous demanderai confirmation avant de continuer — pas de surprises.
Le serveur IA continuera-t-il de fonctionner après votre intervention ?
Oui. Tout est configuré comme un service Docker persistant qui démarre automatiquement au redémarrage. Votre serveur IA fonctionne 24/7 sans intervention manuelle.
