Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur IA et Data Scientist
Je conçois des modèles d'apprentissage profond qui trient les images dans les catégories dont vous avez besoin, comme les types de produits, les défauts, les cultures ou l'utilisation des sols.
Ce que je fais :
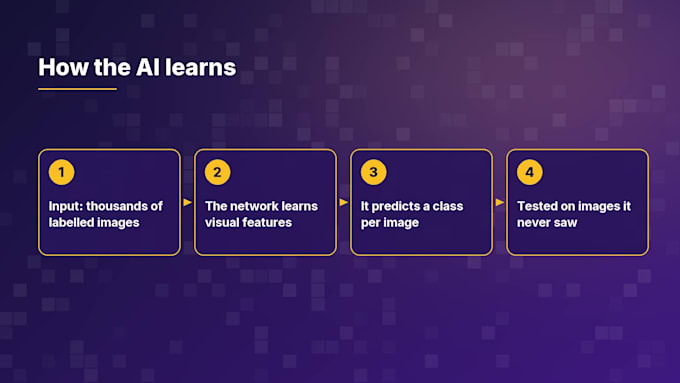
Préparer et augmenter vos images, utiliser l'apprentissage par transfert avec des backbones CNN éprouvés (ResNet, EfficientNet) dans TensorFlow et Keras, ajuster le modèle et le tester sur des images qu'il n'a jamais vues.
Ce que vous obtenez :
Le code, le modèle entraîné, les résultats de précision avec une matrice de confusion, et des instructions claires pour exécuter le modèle sur de nouvelles images.
Pourquoi travailler avec moi :
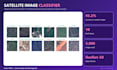
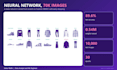
Je suis Ingénieur en ML et data scientist chez Datix AI. Mes travaux récents incluent un classifieur d'utilisation des sols par satellite sur 27 000 images Sentinel-2 (93 % de précision sur le test) et un classifieur d'images de produits en 10 classes sur 70 000 images (90 % de précision).
Envoyez-moi un échantillon de vos images et je vous dirai honnêtement si vous disposez de suffisamment de données avant que nous commencions.

Langage de programmation:
Python
•
Colab
Outils:
Jupyter Notebook
•
opencv
•
tensorflow
Frameworks:
Scikit-learn
•
keras
Traduction automatique
De combien d'images ai-je besoin ?
Avec l'apprentissage par transfert, environ 100 à 300 images claires par classe suffisent souvent pour démarrer. Envoyez-moi un échantillon et je vous dirai honnêtement avant que nous commencions.
Le modèle peut-il fonctionner sur mon ordinateur ou mon serveur ?
Oui. Je livre le modèle enregistré et un script Python simple pour l’exécuter sur de nouvelles images. L’offre premium comprend une exportation allégée pour une utilisation plus rapide sur du matériel normal.
Quelle précision pouvez-vous garantir ?
La précision dépend de vos images et de vos classes, je ne promet donc jamais un chiffre à l'avance. Je mentionne la précision de test sur des images non vues et j’explique où le modèle commet des erreurs.