Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Full Stack Web, DevOps et automatisation IA, The Burujan
Les pertes liées à la fraude font mal, mais les fausses alertes qui bloquent de bons clients le font aussi. Je construis un modèle d’apprentissage automatique de détection de fraude en Python qui repère davantage de fraudes et signale moins de vrais clients.
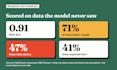
Je suis Huzaifa de The Burujan, ingénieur NOC qui réalise des projets de data science. Mon projet de détection de fraude par carte bancaire utilise 590 540 transactions réelles, où seulement 3,5 % sont des fraudes. Sur un ensemble de test ultérieur que le modèle n’a jamais vu, il a atteint 0,91 ROC AUC, a détecté 71 % des fraudes et a réduit les fausses alertes de 47 % par rapport à un modèle standard avec le même taux de détection des fraudes.
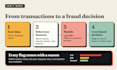
Ce que vous obtenez : nettoyage des données, caractéristiques de comportement telles que l’historique des dépenses et la vitesse d’exécution, gestion du déséquilibre des classes, modèles LightGBM et XGBoost ajustés, seuil de décision basé sur le coût de la fraude par rapport à une fausse alerte, explications SHAP afin que les analystes comprennent pourquoi chaque transaction a été signalée, et un rapport avec un notebook Jupyter. L’option premium ajoute une API de scoring, un plan de surveillance et un guide de réentraînement.
Je répartis les données par temporalité, et non au hasard, afin d’obtenir des résultats honnêtes. Aucun modèle ne peut promettre zéro fraude, et les résultats dépendent de vos données. Contactez-moi avant de commander avec une description succincte de vos données et je vous dirai si cela correspond.
Langage de programmation:
Python
•
SQL
Frameworks:
Scikit-learn
Outils:
Jupyter Notebook
•
Colab
Traduction automatique
Quelles données dois-je fournir ?
Un tableau des transactions passées avec une étiquette de fraude (0 ou 1), sous forme de CSV ou d’exportation de base de données. Plusieurs mois d’historique avec horodatages et montants fonctionnent le mieux. Des champs carte, appareil et e‑mail aident, mais sont optionnels.
Le modèle réduit-il vraiment le nombre de fausses alertes ?
Sur mon projet, il a réduit les fausses alertes de 47 % par rapport à un modèle standard au même taux de détection des fraudes lors d’un test ultérieur. Les résultats dépendent de vos données, j’indique donc les mêmes mesures sur vos propres données retenues.
Pouvez-vous le déployer en tant qu'API ?
Oui. Le package Premium inclut une API de scoring avec notes de transfert. Je travaille en Python avec LightGBM, XGBoost et scikit-learn, et je peux adapter votre stack si vous me dites ce que vous utilisez.


