Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Architecte de solutions IA, ingénieur SaaS full stack et cloud
INGÉNIERIE DE DONNÉES | ETL & ELT | CANAUX DE DONNÉES CLOUD
Vous avez besoin d’automatiser le traitement des données, de connecter plusieurs sources de données ou de construire un canal de données fiable pour votre entreprise ?
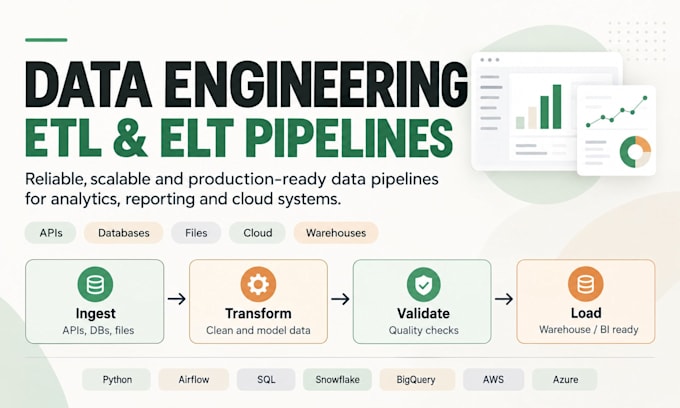
Je développe des pipelines ETL et ELT évolutifs qui collectent, transforment, valident et livrent les données vers des plateformes cloud, bases de données et entrepôts de données pour l’analyse, le reporting et l’intelligence d’affaires.
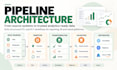
CE QUE JE PEUX CONSTRUIRE
IDÉAL POUR
Plateformes SaaS, intelligence d’affaires, analytique, automatisation du reporting, migration de données et intégration de données d’entreprise.
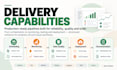
CE QUE VOUS RECEVEZ
Une solution de pipeline structurée adaptée à vos besoins, incluant la source convenue
Traduction automatique
Q : Quel type de pipelines de données pouvez-vous construire ?
Je peux construire des pipelines ETL et ELT pour APIs, bases de données, fichiers, stockage cloud, data warehouses et autres sources de données supportées.
Q : Quelles plateformes de destination supportez-vous ?
Je peux travailler avec Snowflake, Google BigQuery, Amazon Redshift, Databricks Lakehouse, Microsoft SQL Server et d’autres plateformes selon vos besoins.
Q : Pouvez-vous connecter plusieurs sources de données ?
Oui. Les packages Standard et Premium peuvent supporter plusieurs connecteurs et sources de données selon le périmètre convenu.
Q : Pouvez-vous automatiser et planifier le pipeline ?
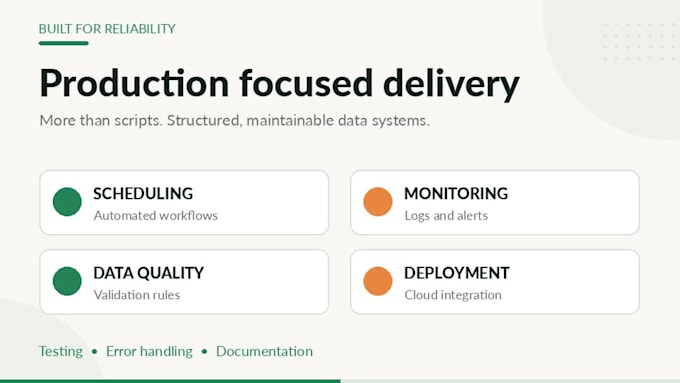
Oui. Les pipelines peuvent inclure l’orchestration, la planification, la gestion des dépendances, les retries et l’exécution automatisée si nécessaire.
Q : Fournissez-vous des contrôles de qualité des données ?
Oui. Je peux mettre en place des règles de validation, des vérifications de schéma, des contrôles de doublons, des vérifications de données manquantes et d’autres contrôles de qualité selon vos données.
Q : Pouvez-vous construire des pipelines de streaming de données ?
Oui. Les besoins en streaming peuvent être gérés dans le cadre du package Premium ou via une offre personnalisée selon l’architecture et les outils nécessaires.
Q : Fournissez-vous des tests et de la documentation ?
Oui. Les tests unitaires et la documentation technique sont inclus selon le package choisi.
Q : Pouvez-vous travailler avec un pipeline de données existant ?
Oui. Je peux revoir, améliorer, étendre ou dépanner un workflow ETL ou ELT existant.
Q : Fournissez-vous une assistance pour le déploiement ?
Oui. Le déploiement peut être inclus selon votre package, l’environnement cloud et l’architecture du pipeline.
Q : Dois-je vous contacter avant de commander ?
Oui. Veuillez me contacter d’abord pour les pipelines complexes, plusieurs connecteurs, systèmes de streaming, migrations cloud ou exigences d’entreprise sur mesure.