Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Analyste de données et Data scientist


Langage de programmation:
Python
•
R
•
SQL
•
NoSQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
RStudio
Traduction automatique
Quelles tâches d'apprentissage automatique proposez-vous ?
Je construis des modèles de classification, régression et clustering pour des données structurées et tabulaires. Les objectifs typiques incluent prévoir un résultat, estimer une valeur ou identifier des groupes. Chaque commande couvre une cible de prédiction ou une question de clustering convenue.
Mes données doivent-elles être nettoyées au préalable ?
Non. Vos données doivent être sous forme de tableau structuré, mais elles n'ont pas besoin d'être prêtes pour le modèle. L'EDA et le prétraitement convenu sont inclus dans les limites du package, tels que le nettoyage, la gestion des valeurs manquantes, l'encodage des catégories et la standardisation des caractéristiques.
Comment sont comptabilisées les limites du package ?
Chaque package couvre une table. Limites : Basic 2 000 lignes / 10 colonnes d'entrée ; Standard 10 000 / 20 ; Premium 30 000 / 30. Les en-têtes ne comptent pas comme des lignes. Les colonnes d'entrée sont comptées avant l'encodage ; une colonne cible est ajoutée lorsque nécessaire.
Que vais-je recevoir avec chaque colis ?
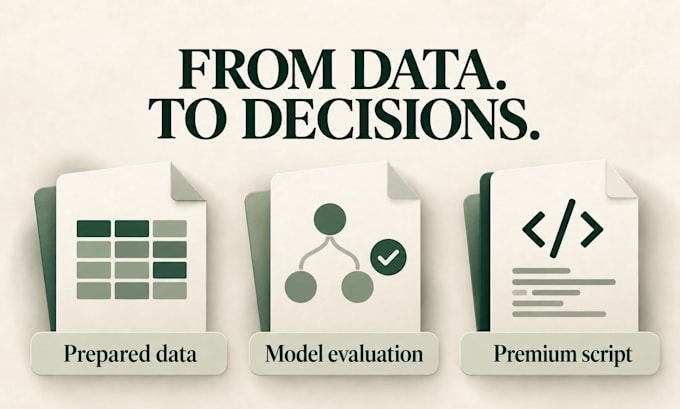
Tous les packages incluent du code commenté, des résultats d'évaluation et de la documentation. Basic couvre un algorithme ; Standard et Premium jusqu'à trois. Premium ajoute un script de prédiction réutilisable et un guide pour les données de même structure. Les ajustements répétés lors du réglage comptent comme le même algorithme.
Quels formats de fichiers et quelles langues prenez-vous en charge ?
J'accepte CSV, Excel (.xlsx) et SPSS (.sav). Python est la valeur par défaut ; R est disponible sur accord. Un dictionnaire de données est utile. L'extraction de base de données, la fusion de tables et la reconstruction manuelle des données nécessitent un périmètre et un devis séparés avant la commande.
Pouvez-vous garantir une précision spécifique ?
Aucune performance spécifique n'est garantie. La performance dépend de la qualité des données, des informations disponibles et de la tâche. Nous évaluons la faisabilité avant la commande. J'applique une validation appropriée et j'explique les performances mesurées et les limites.
Que comprend une révision ?
Une révision est un cycle consolidé d'ajustements dans le cadre convenu. Basic et Standard comprennent une révision ; Premium en comprend deux. De nouvelles analyses, jeux de données, cibles ou livrables nécessitent un devis séparé. Les erreurs lors de la mise en œuvre du travail convenu sont corrigées.
L deployment et la maintenance continue sont-ils inclus ?
Les packages couvrent le développement du modèle et la remise. Le déploiement sur le cloud, l'intégration API, les exécutions planifiées, la surveillance continue et la maintenance échappent au périmètre. Le fine-tuning de modèles pré-entraînés est également séparé. Veuillez discuter de ces exigences avant de commander.
Que dois-je envoyer avant de commander ?
Envoyez votre objectif, le format du fichier, le nombre de lignes et de colonnes, les descriptions des colonnes et un échantillon synthétique ou entièrement anonymisé que vous êtes autorisé à partager. Nous confirmons la faisabilité, les besoins de préparation, les fichiers adaptés et le mode de transfert avant le début des travaux.