Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Formateur en bengali AI traducteur
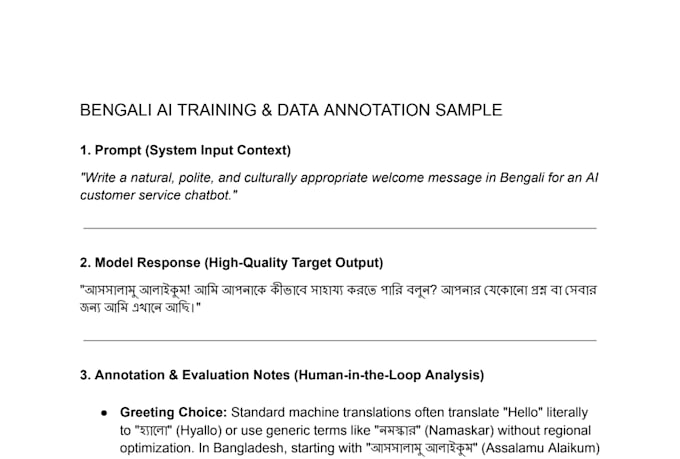
Vous cherchez un locuteur natif bengali pour affiner, annoter ou évaluer des datasets pour vos modèles LLM et AI ? Vous êtes au bon endroit !
Les modèles d'IA sont aussi performants que les données sur lesquelles ils sont entraînés. De mauvaises traductions, une syntaxe peu naturelle et des erreurs culturelles peuvent nuire à la performance de votre modèle. En tant que locuteur natif bengali avec une compréhension approfondie des nuances linguistiques, je propose des services de haute qualité pour rendre votre IA fluide, naturelle et culturellement précise.
Ce que je peux faire pour votre projet d'IA :
Pourquoi me choisir ?


Technique:
Manuel
Type d'identification:
Texte
•
Image
•
Audio
Traduction automatique
Pouvez-vous travailler avec des plateformes d'annotation de données spécifiques comme Labelbox, Scale AI ou des interfaces personnalisées ?
Oui, absolument. Je suis très compétent en technologie et peux m'adapter facilement à toute plateforme tierce ou outil propriétaire que votre entreprise utilise. Vous pouvez simplement m’ajouter à votre espace de travail par email ou partager les identifiants du projet, et je suivrai strictement vos directives.
Comment garantissez-vous la qualité et la précision des données d'entraînement bengali ?
En tant que locuteur natif bengali, je vérifie chaque point de donnée manuellement. Je me concentre fortement sur la précision contextuelle, la syntaxe grammaticale naturelle et l’alignement correct du sentiment. Je n’utilise jamais d’outils automatisés, de bots ou de traducteurs machine pour mon travail, ce qui garantit des données de haute qualité pour votre LLM.
Signerez-vous des accords de non-divulgation (NDA) pour des datasets sensibles ou propriétaires ?
Oui, je comprends que les datasets d'entraînement sont une propriété intellectuelle précieuse. Je traite toutes les données clients avec le plus haut niveau de confidentialité. Si votre équipe nécessite la signature d’un NDA avant de partager l’accès aux données, je suis tout à fait disposé à le revoir et à le signer.
Pouvez-vous gérer des projets de datasets à grande échelle ou des contrats à long terme ?
Oui ! Bien que mes forfaits couvrent des volumes spécifiques, je peux gérer des volumes beaucoup plus importants via des étapes personnalisées. Pour des projets en cours ou des datasets massifs, envoyez-moi un message avec vos besoins, directives et calendrier afin que je puisse créer une offre personnalisée adaptée.