Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr

Traduction automatique
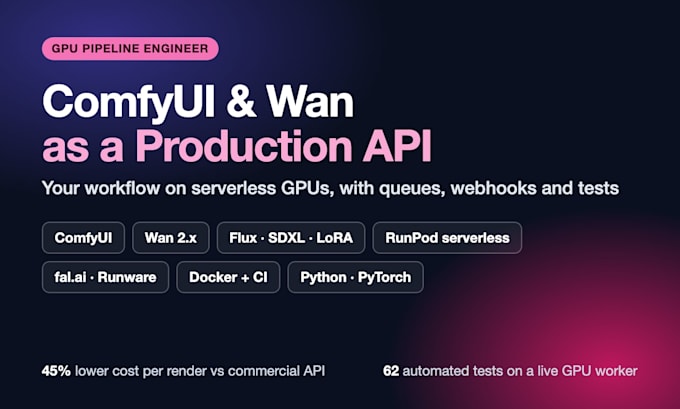
Vous avez un flux de travail ComfyUI qui fonctionne sur votre bureau mais vous souhaitez le faire fonctionner comme une API fiable pour votre application, votre agence ou votre SaaS ?
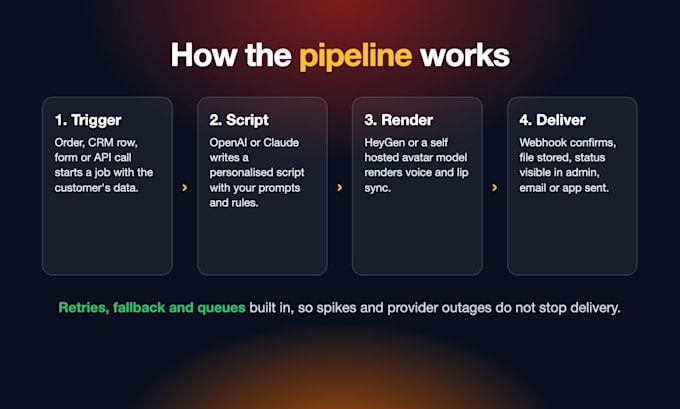
Je transforme les flux de travail ComfyUI, Wan, Flux et Stable Diffusion en services de production : des workers GPU serverless sur RunPod, ou une inférence hébergée via fal.ai et Runware lorsque vous ne voulez aucune infrastructure.
Ce que je construis :
Preuve : un worker d’affichage d’avatar auto-hébergé que j’ai développé comporte 62 tests automatisés et a réduit le coût par rendu d’environ 45 % par rapport à l’API commerciale, avec bascule automatique.
Pile technologique : Python, Docker, RunPod, ComfyUI, PyTorch, Node.js, Supabase.
Contactez-moi d’abord avec votre flux de travail ou votre modèle et je vous répondrai avec un plan et un devis fixe.
AI Developer for AI Agents, n8n Automation, Claude Code and GenAI Video
Langues
Traduction automatique
Traduction automatique
Pouvez-vous l’héberger pour moi ou puis-je disposer de mon propre compte GPU ?
Cela s’exécute sur votre propre compte RunPod, fal.ai ou Runware, vous possédez donc les clés, les données et la facturation. Je mets tout en place, remets l’image Docker et le point d’accès, et montre à votre équipe comment mettre à jour les modèles.
Quels modèles et workflows supportez-vous ?
Des graphes ComfyUI avec nœuds personnalisés, Wan 2.x texte et image vers animation, Flux, SDXL, LoRA, ControlNet, upscalers, suppression de fond et modèles d’avatar parlant. S’il s’exécute sur ComfyUI ou sur Hugging Face, je peux le servir.
Comment faites-vous pour réduire les coûts GPU ?
Des workers serverless qui évoluent jusqu’à zéro, démarrages à froid optimisés avec modèles intégrés, batching et mise en cache, GPUs spot lorsque c’est sûr, et une solution de repli vers un fournisseur hébergé comme fal.ai pour que vous ne manquiez jamais une tâche. Vous voyez le coût par rendu dans les journaux.