Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Cessez de vous fier à des chatbots IA qui ont des hallucinations. Pour obtenir une réelle valeur commerciale des modèles de langage, il faut qu’ils comprennent VOS données.
J’ingénie des agents IA personnalisés, prêts pour la production, et des pipelines Retrieval-Augmented Generation (RAG) qui s’intègrent en toute sécurité à votre base de connaissances d’entreprise propriétaire.
En tant qu’Ingénieur Principal IA/ML, je me spécialise dans le passage de l’IA des cahiers d’expérimentation à des applications logicielles hautement évolutives. Lors de déploiements commerciaux antérieurs, mes architectures LLM personnalisées ont augmenté l’engagement des utilisateurs de 40 %.
Ce que je construis :
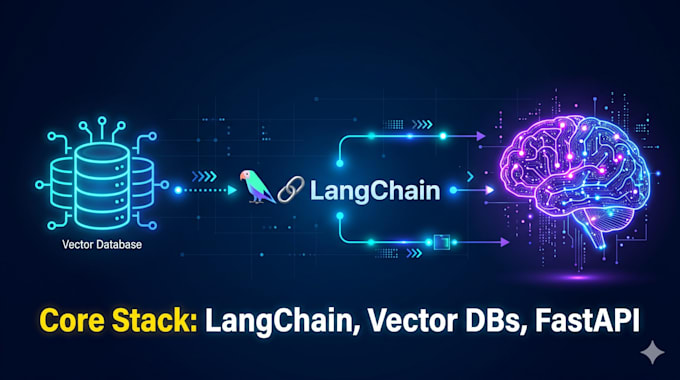
Pile technologique : Python, LangChain, OpenAI, FastAPI, Vector DBs, AWS.
Envoyez-moi un message avec vos objectifs de projet, et démarrons ensemble !
Generative AI, RAG, and Edge Computing Expert
Langues
Traduction automatique
Traduction automatique
Mes données propriétaires seront-elles sécurisées ? Seront-elles utilisées pour entraîner des modèles publics ?
Oui, vos données sont entièrement sécurisées. Je conçois des pipelines RAG à l’aide d’API de niveau entreprise et de bases de données vectorielles dédiées. Vos documents ne sont utilisés que pour la récupération de contexte et ne servent jamais à entraîner des modèles de base comme le GPT public d’OpenAI.
En quoi cela diffère-t-il d’utiliser simplement ChatGPT standard ?
Les LLM standard ont souvent des hallucinations et ne connaissent pas vos opérations internes. Un pipeline RAG personnalisé limite l’IA à extraire des réponses uniquement à partir des documents ou bases de données que vous fournissez, garantissant des réponses très précises et factuelles.
Quels types de données ou de documents l’agent IA peut-il traiter ?
Je peux intégrer une grande variété de sources de données, y compris des PDFs, des fichiers CSV/Excel, des bases de données SQL, des documents Word et des wikis internes comme Notion ou Confluence.
Quelle stack technologique utilisez-vous pour construire le backend ?
J’architecture ces systèmes en utilisant Python, LangChain et LangGraph pour les flux IA. Pour l’infrastructure backend, j’utilise FastAPI et Redis afin de garantir que l’application supporte un trafic élevé (30+ requêtes/s) avec une faible latence, conteneurisé avec Docker.
Aidez-vous au déploiement de l’agent dans le cloud ?
Oui. Si vous choisissez le package Premium Enterprise, je fournis une configuration Docker entièrement conteneurisée et déployable. Elle sera prête à être hébergée sur le fournisseur cloud de votre choix, tel que AWS, GCP ou Azure.