Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Traduction automatique
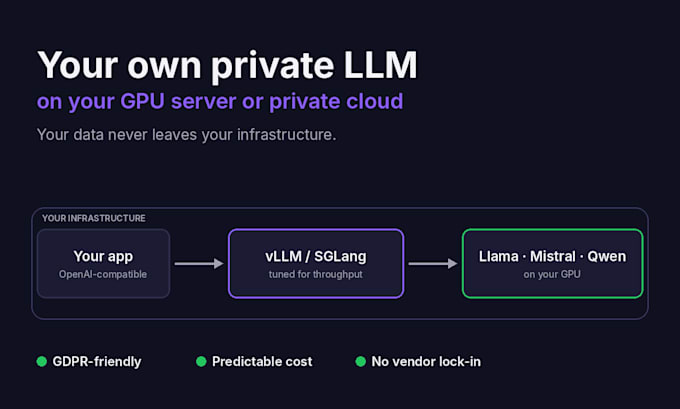
Vous souhaitez une intelligence artificielle de niveau ChatGPT sans envoyer vos données à OpenAI ? Je déploierai un LLM open-source sur votre propre serveur GPU ou dans un cloud privé, afin que vos requêtes et documents ne quittent jamais votre infrastructure.
Je suis ingénieur en IA et j’ai construit et exploité une plateforme IA souveraine en production pour une société d’hébergement néerlandaise comptant plus de 1,4 million d’abonnements. Il s’agit d’un véritable ingénierie d’inférence, et non d’une installation Ollama en un clic.
Ce que je fais :
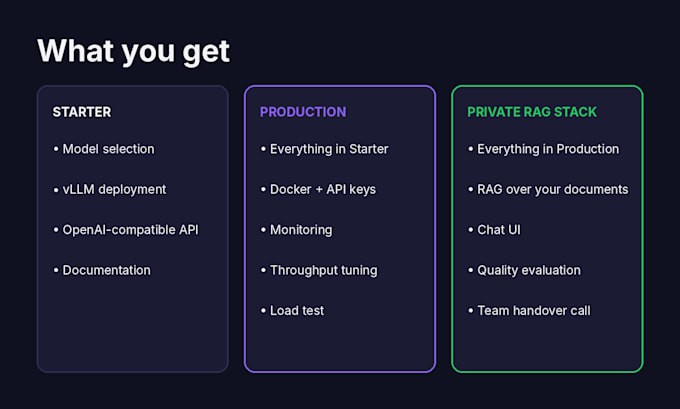
Choisir le modèle adapté à votre tâche et à votre matériel (Llama, Mistral, Qwen, DeepSeek, Gemma)
Le déployer avec vLLM ou SGLang derrière une API compatible OpenAI, afin que votre code existant fonctionne simplement
Ajuster le débit, la latence et la mémoire GPU (quantification, cache KV, batching)
Ajouter Docker, clés API, surveillance et test de charge pour un trafic réel
Optionnel : RAG sur vos propres documents avec une interface de chat
Bon profil pour :
Avoir des exigences en matière de confidentialité, RGPD ou conformité
Payer trop cher les tokens API et rechercher des coûts prévisibles
Posséder déjà des GPUs (sur site, RunPod, Lambda, AWS, Hetzner) ou avoir besoin d’aide pour les choisir
Veuillez me contacter avant de commander avec votre cas d’usage et votre matériel, afin que je puisse confirmer le bon package.
Senior AIML Engineer
Langues
Traduction automatique
Traduction automatique
Ai-je besoin de ma propre GPU ?
Vous avez besoin d’un accès à un serveur GPU : sur site ou loué auprès de fournisseurs comme RunPod, Lambda, AWS ou Hetzner. Si vous n’en avez pas encore, je recommanderai le GPU et le fournisseur adaptés à votre modèle et à votre budget avant votre commande.
Cela fonctionnera-t-il avec votre code OpenAI existant ?
Oui. Le déploiement expose une API compatible OpenAI, de sorte que dans la plupart des cas il suffit de modifier l’URL de base et le nom du modèle dans votre code.
Quel modèle devrais-je utiliser ?
Cela dépend de votre tâche, de la langue et de la mémoire GPU. Je recommande un modèle (par ex. Llama, Mistral, Qwen, DeepSeek ou Gemma) et un niveau de quantification pour obtenir la meilleure qualité que votre matériel peut exécuter rapidement.
Comment accédez-vous à mon serveur ?
Via un utilisateur SSH temporaire ou un compte cloud avec uniquement les permissions nécessaires. Vous pouvez retirer mon accès dès que le travail est livré.
Un modèle auto-hébergé peut-il être aussi bon que GPT-4 ?
Pour des tâches ciblées comme la question-réponse sur des documents, le résumé ou la classification, les modèles ouverts modernes sont souvent suffisants. Pour un raisonnement plus large, ils peuvent être à la traîne. Je vous dirai honnêtement ce à quoi vous attendre pour votre cas d’usage avant de commencer.