Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD



Traduction automatique
Vous souhaitez ajouter de l'IA à votre application sans une démo fragile ou à moitié fonctionnelle ? J'intègre ChatGPT, Claude et d'autres LLM dans votre produit ou backend existant, avec un code propre, testé et prêt pour la production.
Je suis ingénieur backend et IA avec plus de 5 ans d'expérience. J'ai construit une plateforme RAG complète en solo sur FastAPI et pgvector, déployé des fonctionnalités IA avec appel d'outils et garde-fous de sécurité, et réduit les coûts des LLM jusqu'à 90 % grâce à la mise en cache des prompts, pour que votre fonctionnalité reste économique à faire fonctionner.
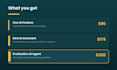
Ce que vous pouvez commander :
Compatible avec Python (FastAPI), Java (Spring Boot), Node et la plupart des stacks. Des options supplémentaires sont disponibles pour des fonctionnalités avancées et un support prioritaire.
Contactez-moi avant de commander avec votre stack et ce que vous souhaitez que l'IA fasse, et je confirmerai le périmètre et le bon package. Réponses rapides, communication claire, transfert propre.
Backend and AI Engineer specializing in LLM, RAG, and Deployment
Langues
Traduction automatique
Traduction automatique
Travaillez-vous avec OpenAI/ChatGPT et Claude (Anthropic) ?
Oui, avec les deux, ainsi que d'autres grands LLM. J'ai déployé des intégrations en production avec OpenAI GPT-4 et Anthropic Claude. Si vous n'êtes pas sûr de celui qui convient à votre cas d'usage et votre budget, indiquez-moi votre objectif et je vous recommanderai l'un et vous expliquerai les compromis.
Cela fonctionnera-t-il avec mon code et ma stack technologique existants ?
Oui. Je m'intègre à votre code actuel plutôt que de le reconstruire. Je travaille régulièrement avec Python/FastAPI et Java/Spring Boot, ainsi que Node et la plupart des stacks courants. Partagez votre repo et je confirmerai si c'est compatible avant votre commande.
De quoi avez-vous besoin de ma part pour commencer ?
Accès à votre code ou repo, une brève description de ce que l'IA doit faire, et votre clé API LLM. Pour un assistant RAG, aussi les documents ou données de référence. Je vous enverrai une courte liste de vérification une fois que nous aurons défini le périmètre.
Les clés API utilisées appartiennent-elles à qui, et qui paie le coût d'utilisation ?
Vous détenez les clés API et payez directement le fournisseur, vous gardez donc le contrôle total sans marges. J'optimise les prompts et utilise la mise en cache quand c'est possible pour réduire vos coûts d'exploitation.
Vous ne savez pas quel forfait vous convient ?
Contactez-moi d'abord. En résumé : Basique = une fonctionnalité IA ; Standard = un assistant basé sur vos données (RAG) ; Premium = un agent qui agit via vos API. Dites-moi votre objectif et je vous orienterai vers le bon niveau ou vous ferai une offre personnalisée.
Q6 : Vais-je obtenir le code source, et mon équipe pourra-t-elle le maintenir ?
Oui. Vous recevez tout le code source, proprement écrit et commenté, avec des notes sur son fonctionnement. J'explique l'intégration pour que votre équipe puisse la maintenir et l'étendre. Rien n'est verrouillé chez moi.
Mes données sont-elles gardées confidentielles ?
Oui. Je n'utilise vos données que pour construire et tester votre intégration, jamais pour autre chose, et je suis prêt à signer un NDA. Pour RAG, vos documents restent dans votre propre base de données/infrastructure.
Pouvez-vous rendre mon IA moins coûteuse à faire fonctionner ?
Souvent, oui. Sur des projets passés, j'ai réduit les coûts des LLM jusqu'à 90 % en utilisant la mise en cache des prompts, le routage des modèles et des prompts plus précis. Indiquez-moi votre configuration actuelle et je vous suggérerai où réduire les coûts.


