Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur Full Stack React, Angular, WP, Ingénieur en vision par ordinateur
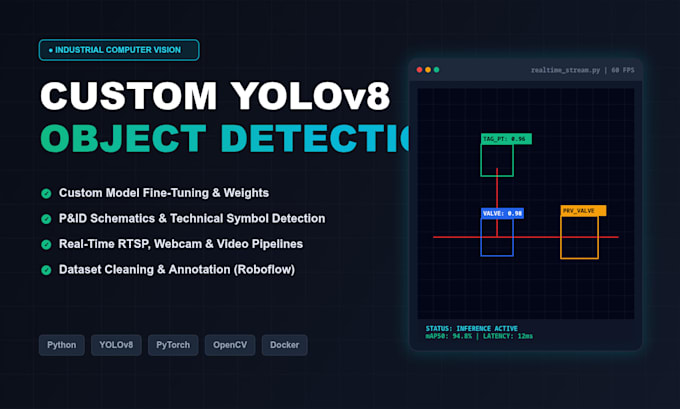
Vous cherchez une solution prête pour la production en vision par ordinateur et détection d’objets ? Je me spécialise dans la formation, l’optimisation et le déploiement de modèles YOLO performants, adaptés à vos spécifications personnalisées.
Fort d’une expérience industrielle dans le réglage fin des architectures YOLO sur des jeux de données réels chez Larsen & Toubro Construction, je fournis des pipelines robustes conçus pour la précision et une faible latence.
Services proposés :
Technologies utilisées : Python, YOLOv8, PyTorch, OpenCV, Roboflow, CUDA, Docker
Pourquoi choisir ce service ?
Veuillez m’envoyer un message avec les détails de votre jeu de données et vos besoins avant de passer commande pour garantir la meilleure approche technique !
Expertise:
Traitement d'images
•
Détection d'objets
Langage de programmation:
Python
•
Colab
Outils:
Jupyter Notebook
•
opencv
•
PyTorch
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Traduction automatique
Que dois-je fournir avant de démarrer le projet ?
Fournissez une brève description des objets que vous souhaitez détecter, l’environnement cible (webcam, CCTV, fichiers vidéo) et votre jeu de données (images ou vidéos). Si vous n’avez pas encore de jeu de données annoté, choisissez le package Standard ou Premium pour que le nettoyage et l’annotation soient pris en charge pour vous.
Que faire si mon jeu de données est petit ou non annoté ?
Dans les packages Standard et Premium, les images brutes sont nettoyées, annotées avec des boîtes englobantes et augmentées à l’aide de Roboflow et OpenCV pour diversifier le jeu de données et améliorer la généralisation du modèle.
Comment puis-je exécuter et tester le modèle sur mon ordinateur ?
Chaque package fournit un code source Python propre, modulaire, les poids du modèle .pt entraînés, un fichier requirements et une documentation claire pour l’installation. Vous recevrez un script d’inférence simple pour tester la détection sur des images, vidéos ou votre webcam en direct immédiatement.
Ai-je besoin d’un GPU coûteux pour exécuter le modèle ?
L’entraînement se fait sur du matériel dédié (comme CUDA/PyTorch), mais le modèle exporté peut fonctionner en inférence sur des CPU standards, des GPU locaux ou des serveurs cloud. Si vous avez des exigences de faible latence, le modèle peut aussi être optimisé ou conteneurisé via Docker pour un déploiement léger.
Pouvons-nous discuter des exigences personnalisées avant de commander ?
Oui. Cliquez sur le bouton Contactez le vendeur pour envoyer votre périmètre de projet, des images d’exemple ou des cas spécifiques avant de passer commande afin de confirmer la bonne architecture et le bon niveau.