Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Nettoyage de données, web scraping et automatisation
Dites-moi quel site public et quels champs vous souhaitez, et je vous les livrerai sous forme de fichier XLSX et CSV propres.
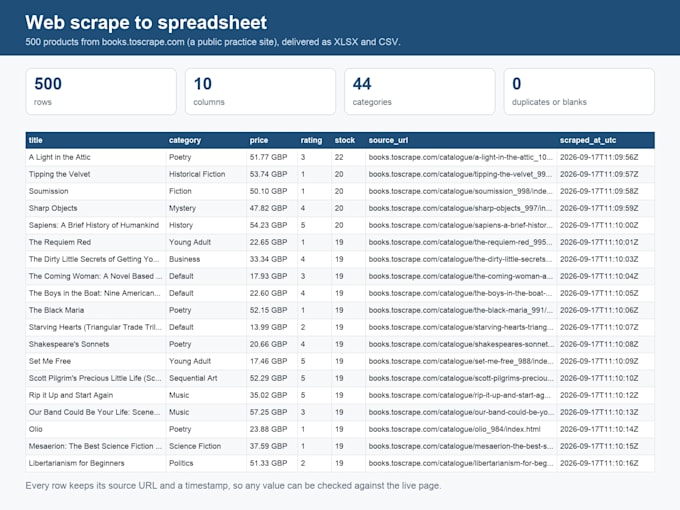
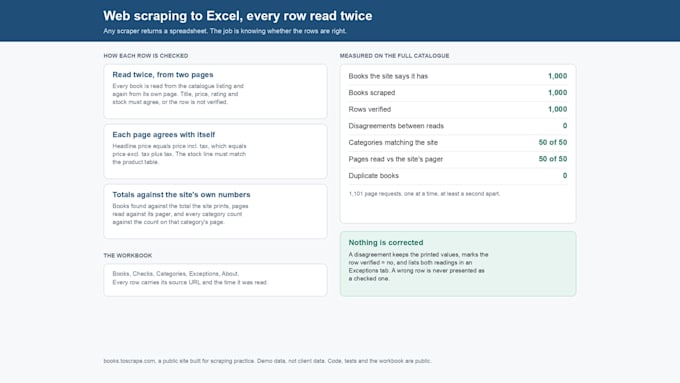
Chaque ligne conserve son URL source et l'heure de la collecte, pour que vous puissiez vérifier n'importe quelle valeur par rapport à la page en direct. Je supprime les doublons, vérifie les champs vides et ajoute un onglet résumé. Mes scripts envoient une requête à la fois avec une pause, pour ne pas surcharger le site.
Dans mon exemple, j'ai collecté 500 produits sur 44 catégories sans doublons ni champs vides. C'est dans mon portfolio.
Ce que je ne fais pas : sites derrière un login, données personnelles sur des individus (noms avec emails ou numéros de téléphone), ou tout ce que les termes du site interdisent clairement. Contactez-moi d'abord avec l'URL et je vous dirai honnêtement si c'est possible et combien cela coûte. Je travaille en anglais et en français.


Technologie:
Python
•
Excel
•
Beautiful Soup
•
Playwright
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Le web scraping est-il légal ?
Collecter des données publiques, non personnelles, à un rythme poli est généralement acceptable. Je vérifie d'abord les termes du site et le fichier robots, je ne scrape jamais derrière un login, et je ne collecte pas de données personnelles. Si un site est interdit, je vous le dis avant que vous payiez.
Pouvez-vous scraper un site nécessitant un login ou un captcha ?
Non. Je travaille uniquement sur des pages accessibles sans compte, et je ne contourne pas les captchas ni les murs anti-bot. Si les données sont disponibles via une API officielle ou une exportation, je l'utiliserai à la place et je vous le dirai.
Que faire si certaines valeurs sont incorrectes ou manquantes ?
Chaque ligne indique son URL source, vous pouvez donc me diriger vers la page exacte. Je corrige l'extraction et la relance le même jour. Les révisions sont illimitées jusqu'à ce que le fichier corresponde au site.