Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur Python, Web Scraping, automatisation de données
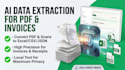
Extraction de données personnalisée avec IA pour PDFs et images
Transformez vos PDFs, documents scannés et images en données structurées grâce à une application d'extraction personnalisée alimentée par IA.
Je configure le logiciel selon vos types de documents et champs spécifiques, afin que vous puissiez extraire des informations et les exporter vers Excel, CSV ou JSON.
Ce que vous obtenez :
Envoyez-moi un échantillon de votre document et les champs que vous souhaitez extraire, je configurerai la solution selon vos besoins.

Traduction automatique
Ai-je besoin de compétences en codage pour utiliser l’application ?
Aucune compétence en codage n'est requise. L'application fonctionne localement pour garantir une confidentialité totale des données. Vous avez seulement besoin d'installer Python pour la lancer, et je fournis un guide PDF étape par étape pour vous montrer comment faire en quelques minutes. Une fois ouverte, vous utilisez simplement l'interface simple.
Que se passe-t-il si j’ai des mises en page de documents non incluses dans mon forfait ?
Si vous choisissez le forfait Premium, vous avez accès au mode prompt gratuit, qui vous permet d’extraire des données JSON brutes à partir de formats de documents non configurés en temps réel.
Comment fonctionne la configuration de la clé API ?
L’application se connecte directement en utilisant votre propre clé API pour garantir la pleine propriété et le contrôle de vos limites de données. Si nécessaire, je peux fournir une clé temporaire pour les tests initiaux.
Comment l'application gère-t-elle les factures multi-pages ou fragmentées ?
L'application propose un outil de fusion visuelle de PDF. Vous pouvez ajuster les curseurs de découpe pour supprimer les en-têtes ou pieds de page indésirables et combiner précisément les sections de différentes pages en un seul PDF propre pour une extraction optimale.


