Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Bio-informatique Knockout Moléculaire Dynamique RNA-seq DTA virtuels
Je validerai les SMILES des composés et les séquences protéiques, lancerai un modèle d’affinité existant et renverrai les prédictions correspondantes, l’état ligne par ligne, un tableau classé et des notes sur le modèle/la version. Basique : jusqu’à 1 000 paires et 20 protéines.
Voies disponibles : DTA bilinéaire, DeepDTA, GraphDTA et une variante à attention croisée ChemBERTa dérivée de MolTrans avec réparation de masque de longueur.
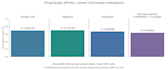
Nos enregistrements sauvegardés utilisent des étiquettes pKi/pKd dérivées de BindingDB Ki/Kd, des divisions NPZ gelées et une évaluation à cible froide (protéines de test tenues hors de l’entraînement). Indices de concordance : bilinéaire 0,695145 ; DeepDTA 0,702238 ; GraphDTA 0,668996 ; variante dérivée de MolTrans réparée 0,636565. Il s’agit de dossiers de points de contrôle propres à chaque voie, et non d’une comparaison de test unique.
Envoyez un échantillon CSV avec les colonnes: sample_id, smiles et protein_sequence ; ajouter compound_id/target_id si disponible. Confirmez le modèle et le classement par cible. Les prédictions permettent la priorisation des candidats.
Les poids et les packages de déploiement exécutables peuvent être fournis par accord distinct après vérifications des actifs et de distribution. Plusieurs modèles, réentraînement et nouvelles divisions de validation constituent des portées distinctes. Contactez-moi avant de commander.

Expertise:
classement
•
Analyse prédictive
Langage de programmation:
Python
Frameworks:
PyTorch
